「品質が低すぎる」から始まった続き
前回の記事では、3Dのスキルがない状態で、Claude CodeにBlenderのスクリプトを書かせてアニメ調キャラを作った。 公開後に見返して、正直に言えば「品質が低すぎる」と感じた。Claudeに聞くと、方法の限界ではなく、崩れを消した時点で作業を止めていたことが原因だという答えだった。 そこで2つのことを試した。1つは同じスクリプトで見た目を作り込むこと、もう1つは画像生成AIと3D生成AIで作ったモデルをClaudeが仕上げる別ルートだ。 あわせて、リップシンクとうなずきを入れ、VTuberのように動かせるようにした。
下のビューアで3体を切り替えられる。「デモ音声」を選んで再生すると、読み上げに合わせて口が動き、文の区切りでうなずく。 「マイク」では自分の声で口が動き、「カメラ」ではWebカメラに映った顔の向き・まばたき・口の開きがモデルに移る。 カメラとマイクの入力はブラウザの中だけで処理し、外部には送らない。
3Dモデルを読み込んでいます…
待機中
今回の作業は分担した。モデルの作り込みとデモ音声の準備、全体の検証はClaude、ビューアの実装はCodex(OpenAIのコーディングエージェント)、AI生成ルートはClaudeの別のエージェントが担当した。 筆者は「両方試して」と「顔写真はCodexに作らせて」と指示しただけだ。
作り込み:スクリプトの修正だけで変わったこと
初版と作り込み版の顔を並べた。左が初版、右が作り込み版だ。形はほとんど変えていない。変えたのは、テクスチャ、法線、細部の部品だ。
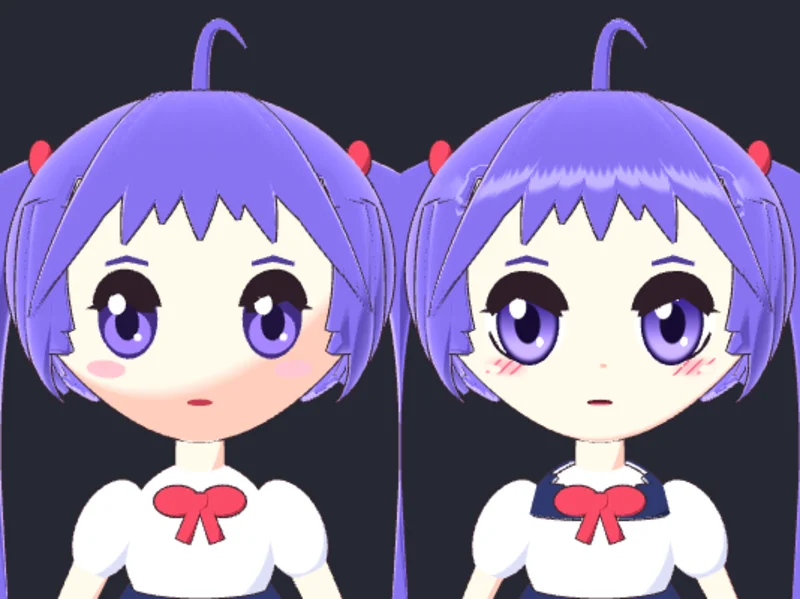
| 変えたところ | やり方 | 効果 |
|---|---|---|
| 顔の影 | 前後に潰した楕円体の法線を顔に写した | 顔の正面の法線が前を向き、光が斜めから当たっても頬に影が落ちない |
| 瞳 | numpyでグラデーション・瞳孔・ハイライトを描いたテクスチャを1枚貼った | 単色の重ね貼りより目に奥行きが出た |
| 目の周り | 白目と目尻側の下まつ毛を足した | 目の形がはっきりした |
| 頬・鼻・口 | 頬はぼかしと斜線のテクスチャ、鼻は小さな点、口は中に舌の色を描いた | 口を開けたときに口の中が見える |
| 髪 | マットキャップで「天使の輪」の光沢を出した | 頭頂の髪につやが出た |
| 服 | セーラー襟を足し、スカートのプリーツを深くした | 上半身の情報量が増えた |
| 手足 | Skinモディファイアで、二の腕から指先まで1本につながった形にした | 筒と球の継ぎ目が消えた |
テクスチャはnumpyで描く
Blenderに同梱されているnumpyで画像の画素を計算し、そのまま画像としてファイルに埋め込んだ。 画像生成AIも外部の素材も使わず、瞳の明るさの変化やハイライトの位置を式で決めている。スクリプト全体はこちらで公開している。
# 説明用に一部簡略化している(全体は公開しているスクリプトを参照)
def iris_tex(u, v):
    # 瞳: 上が濃く下が明るいグラデーション、瞳孔、外周の縁、ハイライト
    x, y = u * 2 - 1, v * 2 - 1
    r = np.sqrt(x * x + y * y)
    c = mix(base("#3a2490"), srgb("#b496ff"), sstep(0.55, -0.60, y))
    pr = np.sqrt((x / 0.42) ** 2 + ((y + 0.02) / 0.48) ** 2)
    c = mix(c, srgb("#140a2e"), sstep(1.05, 0.90, pr))   # 瞳孔
    c = mix(c, srgb("#1a1040"), sstep(0.80, 0.97, r))    # 外周の縁
    for hx, hy, hr in ((-0.30, 0.36, 0.30), (0.38, -0.44, 0.13)):
        hd = np.sqrt((x - hx) ** 2 + (y - hy) ** 2)
        c = mix(c, np.ones(3), sstep(hr, hr * 0.8, hd))  # ハイライト
    return np.dstack([c, np.ones(u.shape)])

img = bpy.data.images.new("IrisTex", 256, 256, alpha=True)
img.pixels.foreach_set(make_pixels(iris_tex).ravel())
img.pack()  # .blendとVRMに画像を埋め込む
テクスチャで描いた瞳・頬・口は、MToonの陰色にも同じテクスチャを掛けている。光の向きに関係なく描いたとおりの色で表示され、絵の部分に陰が落ちない。
継ぎ目のない手足
初版の腕は、袖の球・前腕の筒・手の球を並べただけだった。作り込み版では、関節の位置と太さを並べた点の列をSkinモディファイアに渡し、細分化して1本の滑らかなメッシュにした。 手はミトン形にし、手首から親指の枝を前に出した。骨の重みは、腕がTポーズでX軸に沿っていることを利用し、X座標で上腕・前腕・手に割り振って、関節の前後だけ混ぜている。
VTuberのように動かす
ビューアは、入力を3つ持つ。どの入力も最終的には「表情の目標値」と「頭の向き」に変換され、毎フレーム滑らかに補間してVRMに渡す。
flowchart LR
    A["デモ音声<br/>mp3と口形タイムライン"] --> D["表情の目標値<br/>aa・ih・ou・ee・oh<br/>blink・happy"]
    B["マイク<br/>音量と帯域比"] --> D
    C["Webカメラ<br/>MediaPipe Face Landmarker"] --> D
    C --> E["頭の向き<br/>pitch・yaw・roll"]
    A --> F["うなずき"]
    B --> F
    D --> G["補間してVRMへ"]
    E --> G
    F --> G
デモ音声:読み上げAPIの時刻から口形を決める
デモ音声はElevenLabsの読み上げAPIで作った。with-timestamps 付きのエンドポイントを使うと、音声と一緒に、1文字ごとの開始時刻と終了時刻が返ってくる。 台本は漢字を使わず、かなだけで書いた。かな1文字が1拍に当たるので、文字から母音が決まり、母音から口の形が決まる。
# かな1文字 → 母音 → VRMの口形(aa/ih/ou/ee/oh)
VIS = {"a": "aa", "i": "ih", "u": "ou", "e": "ee", "o": "oh"}
SMALL = {"ゃ": "a", "ゅ": "u", "ょ": "o"}   # 拗音は直前の口形を上書き

for c, t0 in zip(align["characters"], align["character_start_times_seconds"]):
    h = to_hiragana(c)
    if h in SMALL:
        visemes[-1]["v"] = VIS[SMALL[h]]
    elif h in VOWEL:                   # 「か」→ a、「し」→ i など
        visemes.append({"t": t0, "v": VIS[VOWEL[h]]})
    else:                               # 「ん」「っ」、句読点は口を閉じる
        visemes.append({"t": t0, "v": "sil"})
        if h in "。!?":
            nods.append({"t": t0 + 0.05})  # 文の終わりでうなずく
10秒弱のあいさつから、口形の切り替え62回と、うなずき4回のタイムラインができた。再生中は、現在の口形の重みに音量を掛けて、声の強弱で口の開き方が変わるようにしている。
マイク:音量と周波数の帯域比
マイクの声は文字にしないので、母音は推定するしかない。母音は、声に含まれる強い周波数の組み合わせ(フォルマント)で聞き分けられている。 そこで、200〜500Hz、500〜1000Hz、1000〜2200Hz、2200〜3500Hzの4つの帯域のエネルギー比から、あいうえおの割合を大まかに配分した。 口の開きは音量で決める。0.6秒以上話した後に0.5秒以上黙ると、話の区切りとみなして1回うなずく。
カメラ:MediaPipeの表情値をVRMに写す
Webカメラの映像は、GoogleのMediaPipe Face Landmarkerに渡す。顔の478点の位置に加えて、ARKitと同じ名前の52種類の表情値と、頭の回転を表す行列が返ってくる。 これをVRMの表情に対応付けた。画面は鏡のように見せたいので、左右の目と、頭の左右の向き・傾きは入れ替えている。
| MediaPipeの値 | VRMの表情 | 補正 |
|---|---|---|
| eyeBlinkLeft / Right | blinkRight / blinkLeft | 左右を入れ替え、0.35〜0.65を0〜1に広げる |
| jawOpen | aa | 1.4倍する |
| mouthFunnel / mouthPucker | ou / oh | そのまま |
| mouthStretch / mouthSmile | ee / ih | 笑顔の値は0.6倍 |
| mouthSmile | happy | 0.35を引いてから使う |
| 顔の変換行列 | 首と頭の回転 | 回転を半分ずつ首と頭に配分し、左右は反転 |
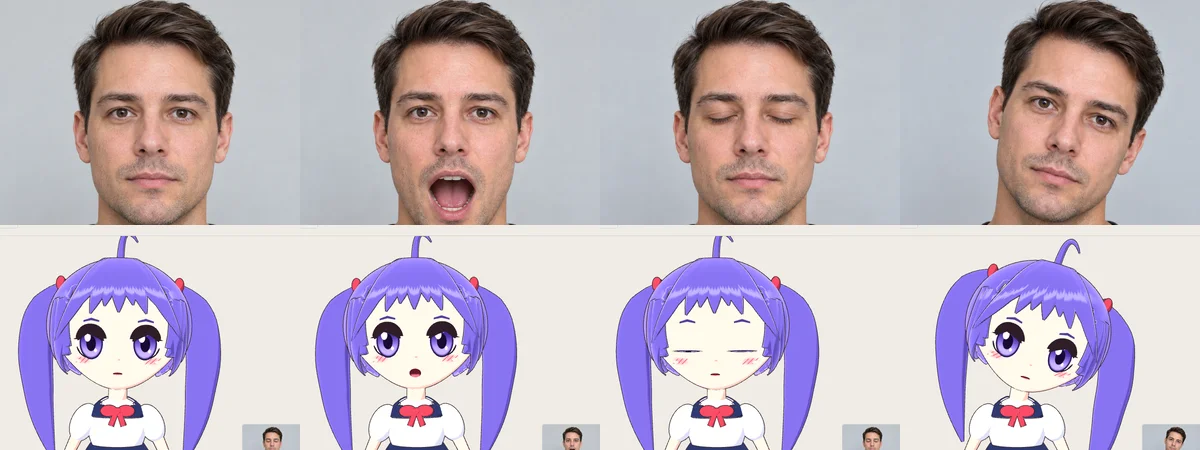
検証には、Codexに画像生成させた架空の人物の顔写真を使った。真顔・口を開ける・目を閉じる・首を傾けるの4枚を2秒ずつつないだ映像を、Chromiumのテスト用の偽カメラとして流している。 上が入力(鏡写しに反転)、下がビューアの反応だ。
ハマったところ
まばたきが止まったまま戻らない
カメラの検証で、口と首は動くのに、目を閉じた写真でもモデルの目が閉じなかった。MediaPipeの値を直接見ると、目を閉じた写真では0.7前後と、正しく検出されていた。
原因はモデルとビューアの組み合わせにあった。モデルの「喜」の表情には、出ている間はまばたきを止める設定(overrideBlink: block)を付けていた。笑顔の「^ ^」の目にまばたきが重なると崩れるからだ。 一方、ビューアは表情の値を指数関数的に目標へ近づけるので、値はちょうど0にならない。カメラは真顔でも微笑みを0.1ほど拾い、「喜」がわずかに残り続けていた。VRMの block は、値がわずかでも0より大きければまばたきを完全に止める。 デモ音声でも、冒頭で笑顔を出した後は同じ理由でまばたきが止まっていた。
補間後の値が0.01未満なら0にそろえ、カメラの微笑みは0.35を引いてから「喜」に使うようにした。目を閉じても0.7前後で頭打ちになる値は、0.35〜0.65を0〜1に広げた。
頭ボーン基準の構図で顔が切れる
Codexの実装は、頭のボーンの位置を基準にバストアップの構図を決めていた。VRMの頭のボーンは首の付け根にあるので、等身の高いモデルならそれで合う。 しかしこのキャラは2.5頭身で頭が大きく、画面の上で顔が切れた。モデル全体の高さと頭頂の位置から、頭頂から胸元までが入る構図に直した。
別ルート:AI生成モデルをClaudeが仕上げる
比較のため、同じキャラ設定(紫のツインテール、白いブラウス、紺のスカート、赤いリボン)で、画像生成AIと3D生成AIの組み合わせも試した。 Claudeの別のエージェントに、立ち絵の生成から3D化、VRMへの仕上げまでを任せた。
- 立ち絵:Geminiの画像生成は、使ったキーの無料枠では利用できず、エラー(429)になった。代わりに、Hugging Face上のFLUX.1-schnellで3枚作り、3D化に向く1枚を選んだ
- 3D化:Hugging Face上のHunyuan3DやTRELLISは、ログインなしで使える無料のGPU枠をすぐに使い切り、1回も完了しなかった。手元のMac(M3 Pro)のCPUでTripoSRを動かし、約1分20秒でテクスチャ付きのメッシュを得た
- 仕上げ:Blenderのスクリプトで、向きと大きさの調整、ポリゴン削減(13万→2万三角形)、メッシュの寸法から骨を配置して自動で重み付け、MToonへの変換、VRMでの書き出しまでを約12秒で行った
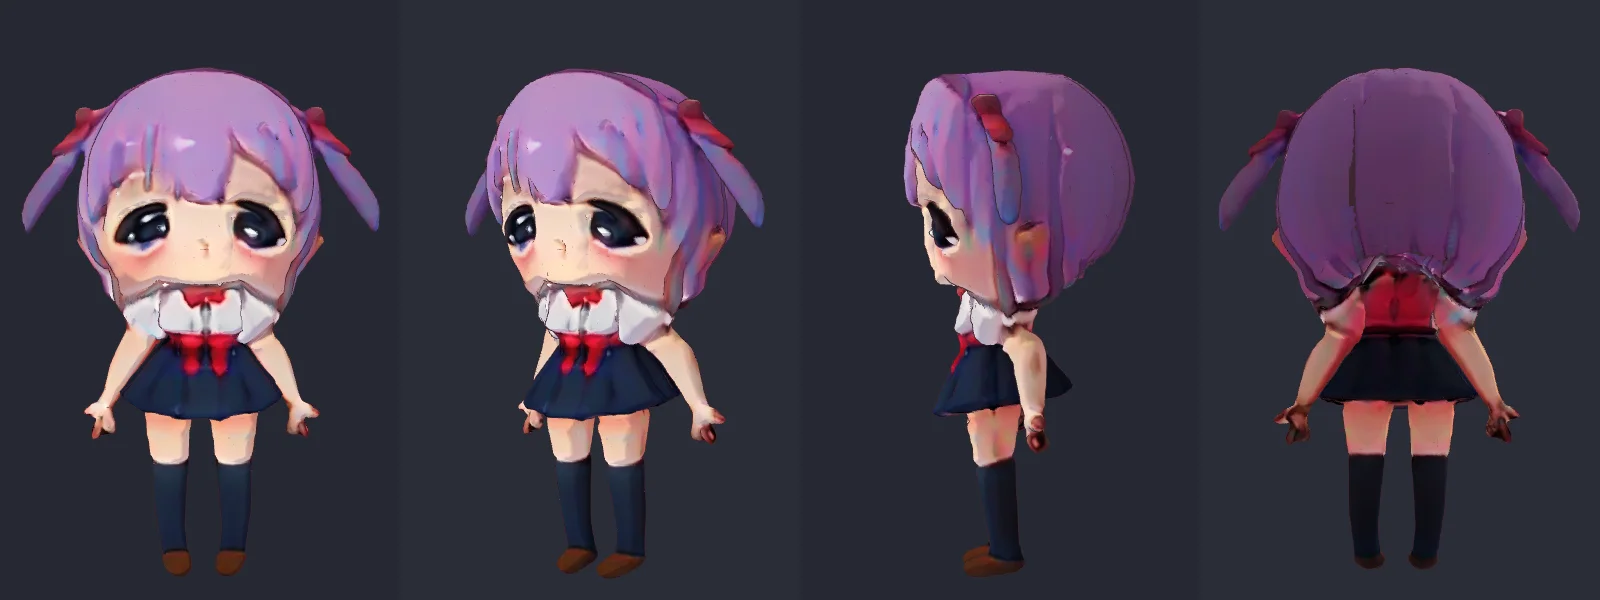
正面の配色とシルエットは、立ち絵をよく再現している。しかし顔は、目が暗くくぼんで見え、あごの下に灰色の帯が出た。後頭部は推測で塗られ、手の指は溶けている。 テクスチャには立ち絵の陰とハイライトが焼き込まれていて、MToonのトゥーンの陰と二重になる。
VTuberとして一番困ったのは表情だ。生成されたメッシュには、目や口を動かすためのシェイプキーがない。 エージェントは、テクスチャの色から目と口の位置を探し、その上に「まぶたの板」と「口の中の板」を貼って、まばたきとあいうえおの口だけを作った。 リップシンクには最低限使えるが、まばたきは肌色の板が目にかぶさるだけで、横から見ると板が浮いて見える。喜怒哀楽のように眉や目の形を変える表情は作れなかった。
3体を比べる
| 初版 | 作り込み版 | AI生成版 | |
|---|---|---|---|
| 作り方 | Claudeがスクリプトで造形 | 初版のスクリプトを修正 | FLUX → TripoSR → Claudeがスクリプトで仕上げ |
| ファイルサイズ | 2.1MB | 2.3MB | 7.2MB |
| 三角形の数 | 約3.9万 | 約4.2万 | 約3万(うち表情用の板が約1万) |
| 正面の見た目 | 素朴なデフォルメ | アニメ調として成立 | 立ち絵に近いが、目と口元が不気味 |
| 横・後ろ | 破綻なし | 破綻なし | 推測で塗られ、崩れがある |
| 表情 | 12種類(喜怒哀楽・まばたき・あいうえお) | 12種類 | まばたきとあいうえおのみ(貼った板) |
| リップシンク・トラッキング | 使える | 使える | 口とまばたきだけ使える |
正面の1枚絵としての「それらしさ」は、AI生成版がいちばん早く手に入る。 しかしVTuberとして動かすと、表情を最初から設計しているスクリプトの2体の方がはるかに扱いやすい。目や口を貼り絵にしておけば、表情は2Dの変形として後からいくらでも足せるからだ。 3D生成AIの出力は「動かすための構造」を持たない塊で、動かすための仕組みは結局、後から作り足すことになる。
まとめ
- 初版の品質の低さは方法の限界ではなかった。テクスチャ、法線、細部の部品をスクリプトに足すだけで、見た目は大きく変わった
- デモ音声は読み上げAPIの文字ごとの時刻からかな→母音→口形を決め、文末でうなずかせた。マイクは音量と帯域比、カメラはMediaPipeの表情値と頭の回転を使った
- VRMの
overrideBlink: blockと、0にならない指数補間の組み合わせで、まばたきが止まり続ける不具合が出た。小さな値を0にそろえて直した - AI生成版は正面の再現度は高いが、表情を持たない塊だった。VTuber用途では、表情を設計して作れるスクリプトの方が向いていた
理解度チェック
作り込み版で、光が斜めから当たっても顔に影が落ちないようにした方法はどれか。
キーボード: 1〜4 で選択、Enter で回答